监督学习这几年热度一直没降过,不管是做算法岗的还是刚转行学AI的,都绕不开它。但说实话,我刚开始学的时候也是一头雾水,网上的资料要么太学术,要么讲得云里雾里。今天我就把自己踩过的坑和2026年最新的实战经验整理出来,用大白话聊聊监督学习常见的那些问题。不管你是想入门还是想复习,看完这篇应该能有个清晰的思路,知道该从哪儿下手、哪些地方容易翻车。
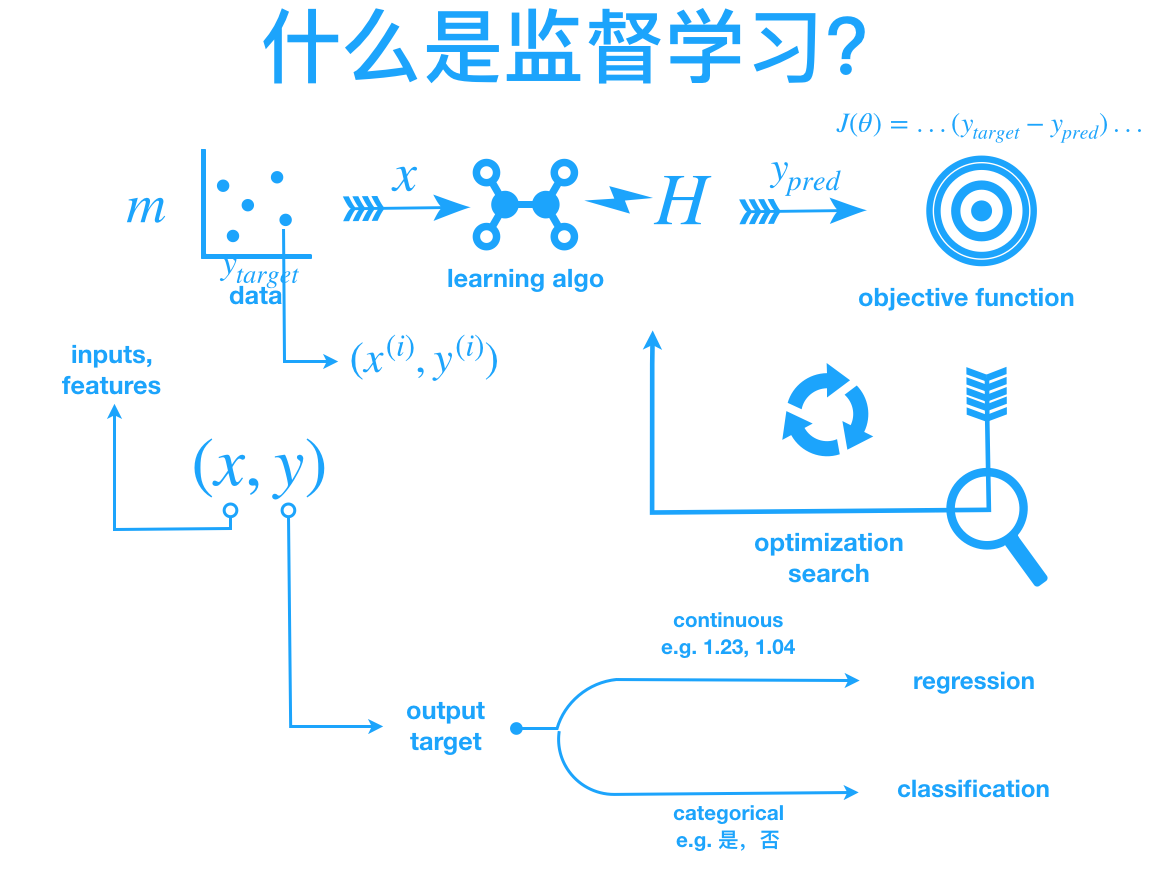
2026年监督学习热门算法实战排行
现在网上教程五花八门,到底哪些算法在实际工作中用得最多?我结合自己和身边同事的项目经验,整理了个实用排行,新手照着学准没错。
| 算法名称 | 上手难度 | 实战使用频率 | 适合场景 |
|---|---|---|---|
| 逻辑回归 | 低 | 非常高 | 二分类、风控、CTR预估 |
| 决策树与随机森林 | 低 | 高 | 特征重要性分析、中等规模数据 |
| XGBoost/LightGBM | 中 | 非常高 | 竞赛、结构化数据、工业级应用 |
| 支持向量机SVM | 中高 | 中 | 小样本、文本分类 |
| 神经网络 | 高 | 高 | 图像、语音、复杂模式识别 |
如果你时间有限,我建议先把逻辑回归和树模型吃透,这两个在实际工作中能解决七八成的问题。神经网络虽然火,但调参和算力门槛摆在那,新手别一上来就死磕。
监督学习的督怎么学?从零开始该按什么顺序学?
很多人一上来就问我要不要先学数学,我的答案是:边用边补,别死磕理论。先找个简单的项目跑通,比如用sklearn做个房价预测,知道整个流程长什么样,再回头补线性代数、概率论这些。上来就啃西瓜书,大概率坚持不到第三章。
学监督学习需要什么基础?数学不好能学会吗?
说实话,高中数学水平就够开始了。微积分、线代、概率论当然重要,但不需要你手推公式。会用numpy做矩阵运算,理解损失函数是在干什么,梯度下降大概怎么回事,就能上手了。遇到不懂的再查,效率比系统啃教材高得多。
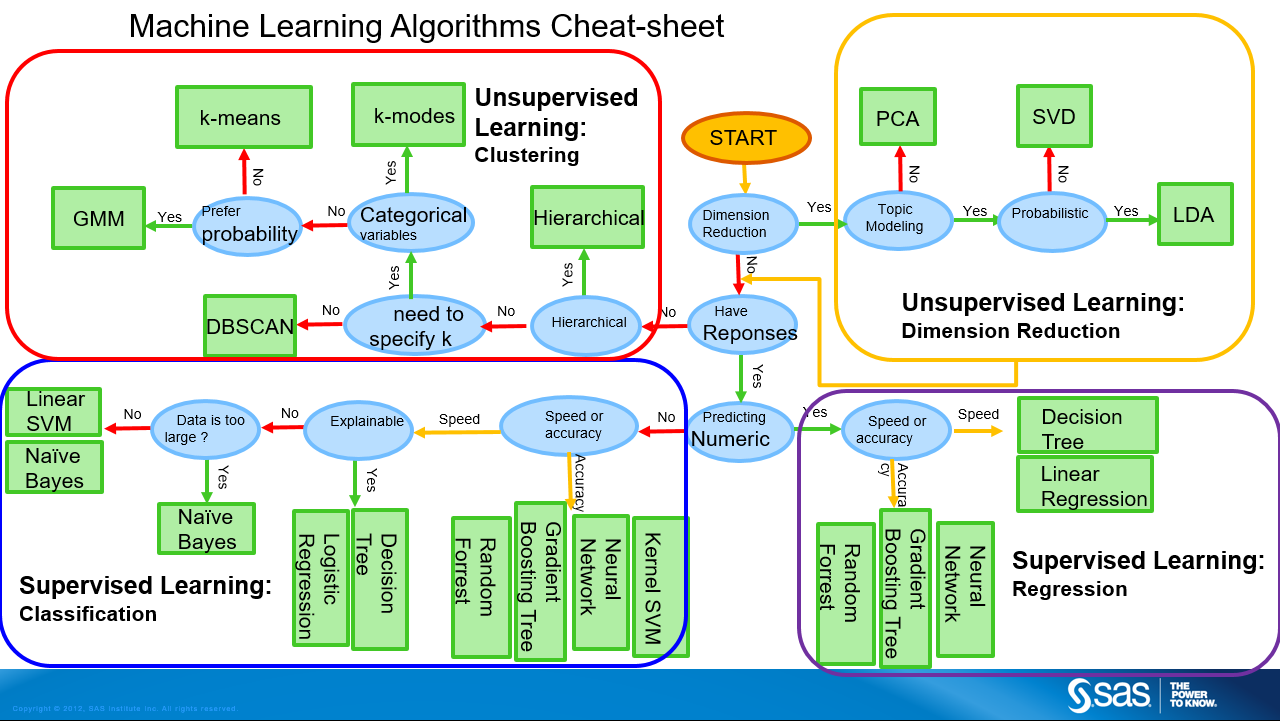
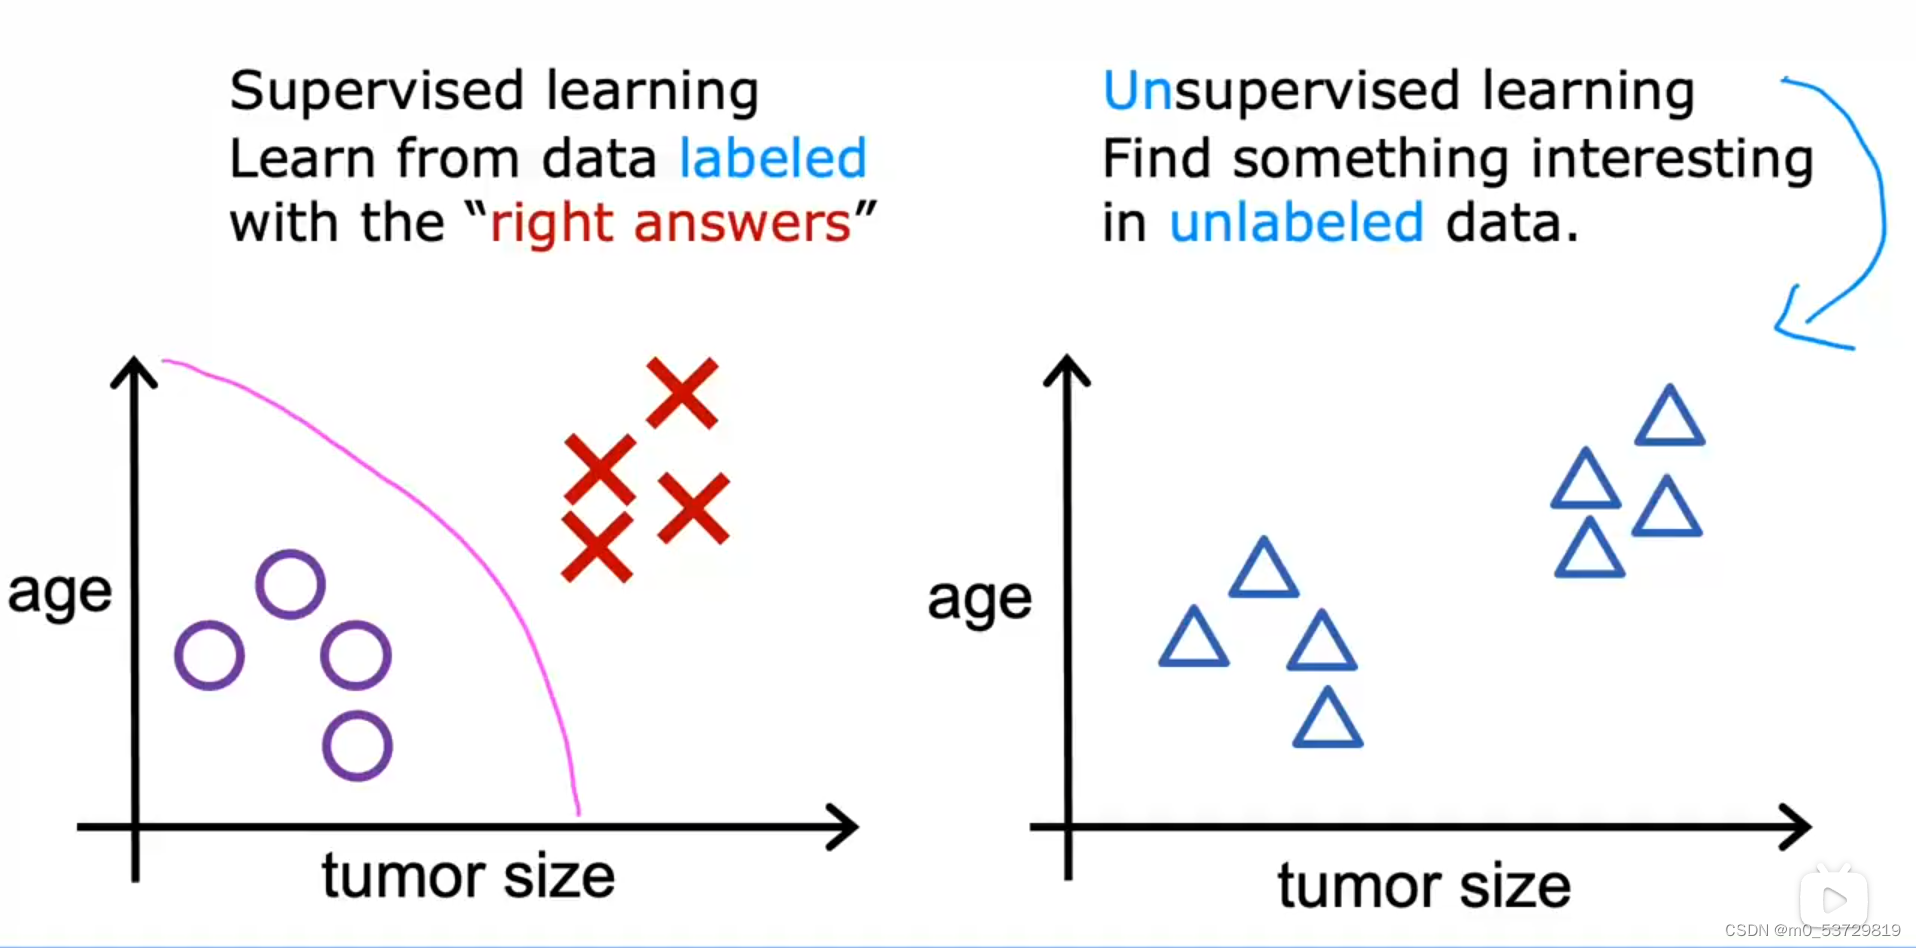
监督学习和无监督学习到底怎么区分?
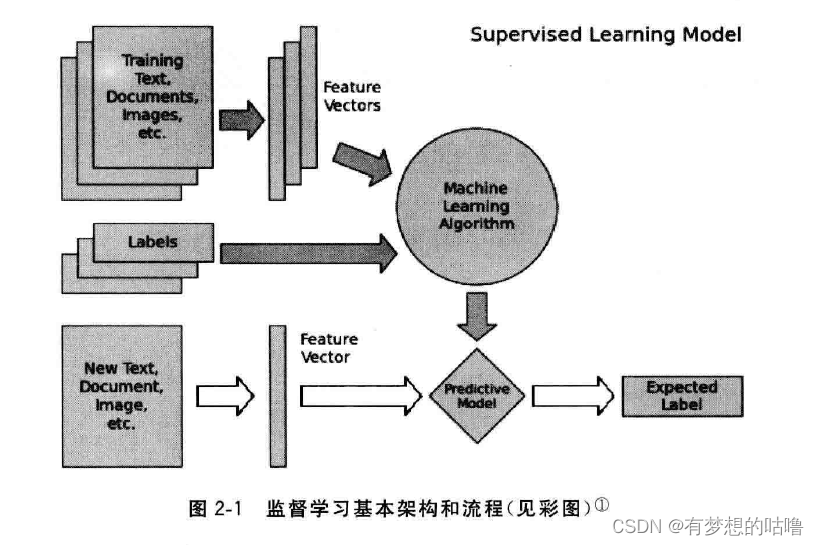
最简单的判断方法:看数据有没有标签。比如你有一堆邮件,每封都标了“垃圾”或“正常”,那就是监督学习。如果只有邮件内容没有标签,让你自己找规律,那就是无监督。2026年实际项目里,监督学习用得更多,因为效果更可控。
2026年学监督学习用什么工具和框架比较靠谱?
Python还是绝对主流。scikit-learn必须熟练,经典算法都在里面。XGBoost和LightGBM做结构化数据比赛和工业部署基本是标配。深度学习这块,PyTorch现在风头盖过TensorFlow,新手直接从PyTorch入手就行。别贪多,先把一个框架用熟。
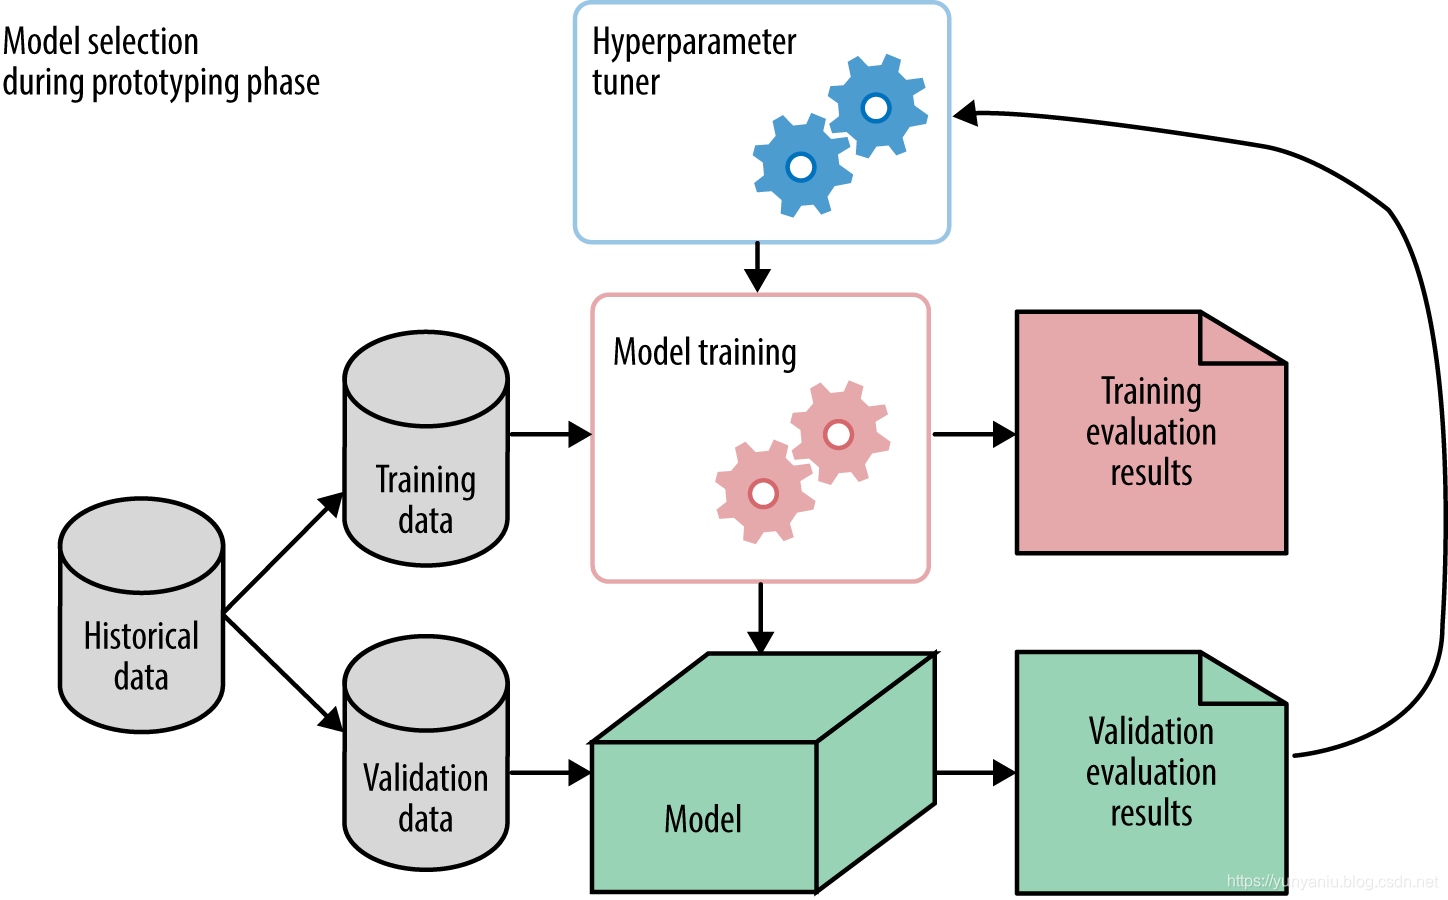
监督学习模型训练好了,怎么判断它到底行不行?
千万别只看准确率!我见过太多人栽在这上面。分类问题重点看召回率和AUC,回归问题看MAE和R。还要注意过拟合,训练集表现好不代表线上效果好。一定要留验证集,交叉验证也跑一跑,心里才有底。
数据量少、标注贵,监督学习还能做吗?
能。2026年有几个实用思路:数据增强把现有样本变出更多花样;迁移学习拿预训练模型微调,小样本也能出效果;半监督学习用少量标注加大量未标注数据一起训。别硬堆标注,成本扛不住。
监督学习项目实战最容易踩的坑有哪些?
说几个我亲身踩过的:数据泄露,把未来信息混进特征里,线下AUC高得离谱上线就崩;特征工程没做好,光调模型参数,其实特征才是天花板;不关注业务指标,模型指标好看但业务不买账。记住,数据和特征决定上限,模型只是逼近这个上限。
2026年监督学习还有前途吗?会不会被大模型取代?
放心,监督学习不会消失。大模型再强,很多具体业务场景还是需要轻量、可控、可解释的监督学习方案。比如风控、推荐、工业质检,这些场景要求低延迟、高稳定,大模型不一定合适。2026年更现实的做法是把监督学习和LLM结合,各取所长。
新手学监督学习,推荐哪些练手项目和数据集?
别一上来就搞图像识别。推荐几个经典又好上手的:Titanic生存预测练分类流程,房价预测练回归,鸢尾花分类理解基础概念。数据集去Kaggle和UCI找,都是免费的。做完一个完整的项目,比看十篇教程都管用。
监督学习调参有什么实用技巧?
先粗后细,别一上来就网格搜索跑一整天。先用手动调或者随机搜索定个大概范围,再在附近细化。树模型重点调学习率、树的深度、叶子节点数。神经网络重点调学习率、batch size、网络层数。记住,参数不是越多越好,够用就行。
此内容由AI根据文章内容自动生成,并已由人工审核

 喜欢
 顶
 难过
 囧
 围观
 无聊
 监督学习常见问
 2026萝卜凹凸转
 欢乐拳皇怎么玩
 格物云哨是什么